統計指標#
教科書 p.343(Lesson 12.2)まずは与えられた大量のデータの基本的な統計指標を理解するところから始めましょう。
Python で与えられたデータから統計指標を導出するには、statistics モジュールを利用します。
統計指標を算出するためのサンプルプログラム#
import statistics as stats

data = [ 91, 65, 85, 66, 73, 98, 2, 90, 81, 85, 30, 81, 65, 96, 85, 75, 57, 28, 80, 98, 80,
         101, 105, 73, 54, 88, 11, 93, 13, 68, 114, 50, 77, 3, 87, 71, 60, 88, 89, 72, 100,
         76, 74, 79, 79, 67, 60, 68, 81, 70, 78, 66, 50, 6, 66, 75, 66, 58, 7, 55, 74, 69,
         90, 71, 84, 86, 86, 76, 14, 61, 70, 92, 68, 95, 92, 98, 102, 93, 71, 72, 54, 79, 114,
         87, 79, 104, 74, 66, 94, 83, 0, 39, 93, 33, 98, 92, 99, 79, 83, 6, 77, 87, 82, 55, 82,
         72, 88, 87, 94, 0, 86, 0, 95, 87, 9, 99, 114, 61, 95, 97, 91, 91, 89, 57, 97, 82, 51,
         53, 81, 82, 60, 78, 91, 101, 66, 89, 67, 77, 66, 73, 63, 73, 95, 74, 98, 3, 69, 89,
         72, 20, 63, 87, 98, 68, 95, 86, 88, 95, 79, 11, 104, 76, 104, 79, 97, 7, 95, 87,
         60, 95, 99, 86, 86, 81, 0, 96, 65, 98 ]
print(f"平均値 {stats.mean(data)}")
print(f"中央値 {stats.median(data)}")
print(f"最頻値 {stats.mode(data)}")
print(f"分散   {stats.pvariance(data)}")
print(f"標準偏差 {stats.pstdev(data)}")実行結果#
平均値 72.91573033707866
中央値 79.0
最頻値 95
分散   699.5378424441359
標準偏差 26.44877771172301
リストで用意された分析対象のデータに対して、平均値、中央値、最頻値、分散、標準偏差を求めるには、
statisticsモジュールの mean, median, mode, pvariance, pstdev 関数を利用します。
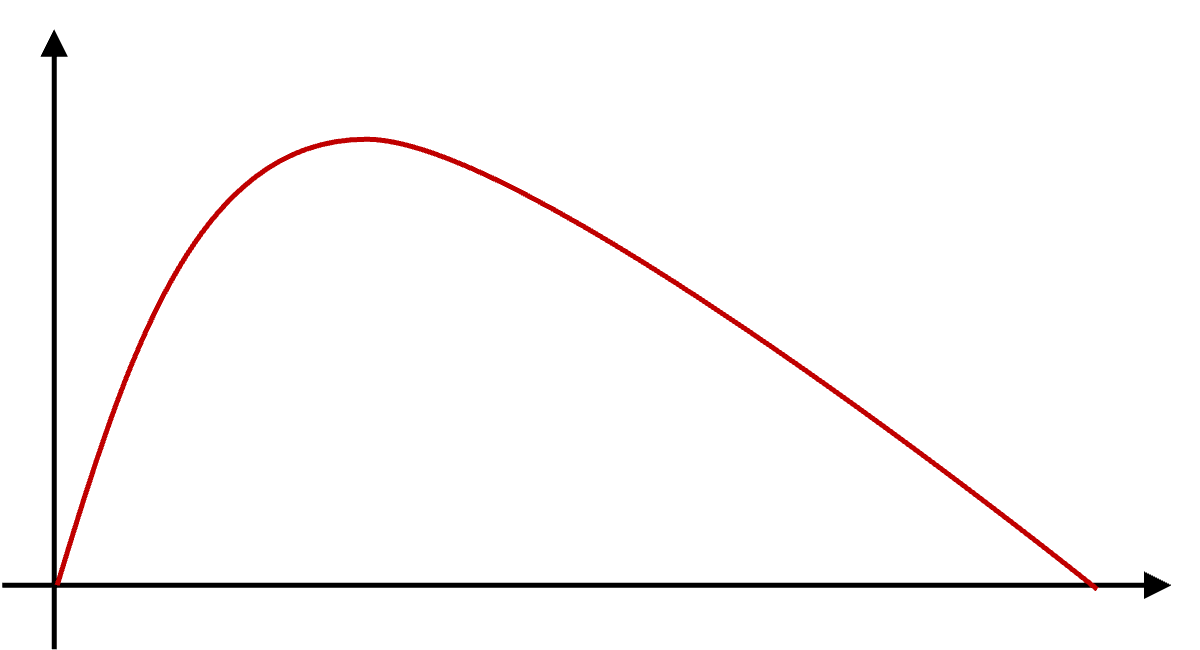
平均値、中央値、最頻値は、データの中央を表す指標です。 平均値は、データの合計をデータの個数で割った値で、データの中心を示す指標です。 最頻値は、データの中で最も頻繁に出現する値で、ヒストグラムで表したときに最も高い山の頂点になります。 中央値は、データを小さい順に並べたときに真ん中に位置する値で、データの偏りを示す指標です。中央値より小さい値の数と大きい値の数が同じになります。
一方、分散と標準偏差は散らばりを表す指標です。 分散(variance)はデータが平均からどの程度散らばっているかを表す指標です。各データと平均との差の二乗の平均値です。 標準偏差(standard deviation)は、分散の平方根であり、分散と同じくデータの散らばりを表す指標です。 分散が元データの単位の2乗であるのに対し、標準偏差は元データの単位と同じです。 データのばらつきが大きいほど、分散と標準偏差は大きくなります。
AverageとMeanの違い
AverageもMeanも共に「平均」という意味ですが、Averageは日常会話などで用いられる一般的な平均という意味であり、 Meanは数学/統計学/機械学習などの専門的な文脈の中で使われる平均値という意味です。 統計学では、Averageは代表値という意味もあり、平均値だけでなく、中央値(median)、最頻値(mode)も含まれるようです。
データの可視化#
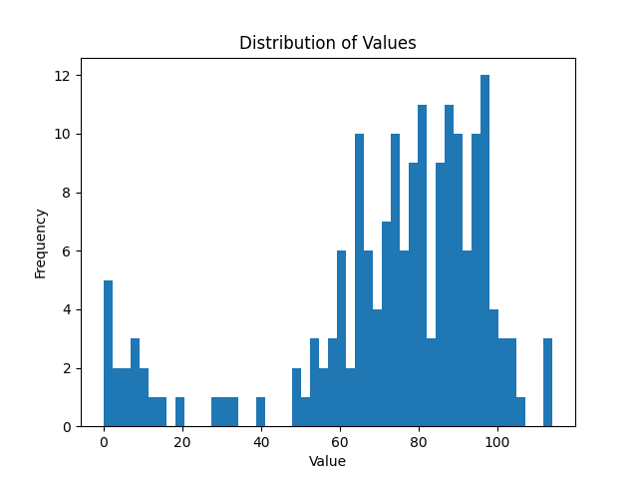
与えられたデータの統計値がどのような値になっているか、実際にグラフを描画して確認してみましょう。
import matplotlib.pyplot as plt

data = [ 91, 65, 85, 66, 73, 98, 2, 90, 81, 85, 30, 81, 65, 96, 85, 75, 57, 28, 80, 98, 80,
         101, 105, 73, 54, 88, 11, 93, 13, 68, 114, 50, 77, 3, 87, 71, 60, 88, 89, 72, 100,
         76, 74, 79, 79, 67, 60, 68, 81, 70, 78, 66, 50, 6, 66, 75, 66, 58, 7, 55, 74, 69,
         90, 71, 84, 86, 86, 76, 14, 61, 70, 92, 68, 95, 92, 98, 102, 93, 71, 72, 54, 79, 114,
         87, 79, 104, 74, 66, 94, 83, 0, 39, 93, 33, 98, 92, 99, 79, 83, 6, 77, 87, 82, 55, 82,
         72, 88, 87, 94, 0, 86, 0, 95, 87, 9, 99, 114, 61, 95, 97, 91, 91, 89, 57, 97, 82, 51,
         53, 81, 82, 60, 78, 91, 101, 66, 89, 67, 77, 66, 73, 63, 73, 95, 74, 98, 3, 69, 89,
         72, 20, 63, 87, 98, 68, 95, 86, 88, 95, 79, 11, 104, 76, 104, 79, 97, 7, 95, 87,
         60, 95, 99, 86, 86, 81, 0, 96, 65, 98 ]

plt.hist(data, bins=50)
plt.xlabel("Value")     # x軸のラベル:値の範囲
plt.ylabel("Frequency") # y軸のラベル:度数
plt.title("Distribution of Values") # タイトル
plt.show()