回帰分析#
教師あり学習の一つである回帰分析(regression analysis)は、目的となる値(連続値)を予測するための手法です。 その中でも、入力データと目的となる値の関係が直線で表現できると仮定するのが線形回帰(linear regression)です。
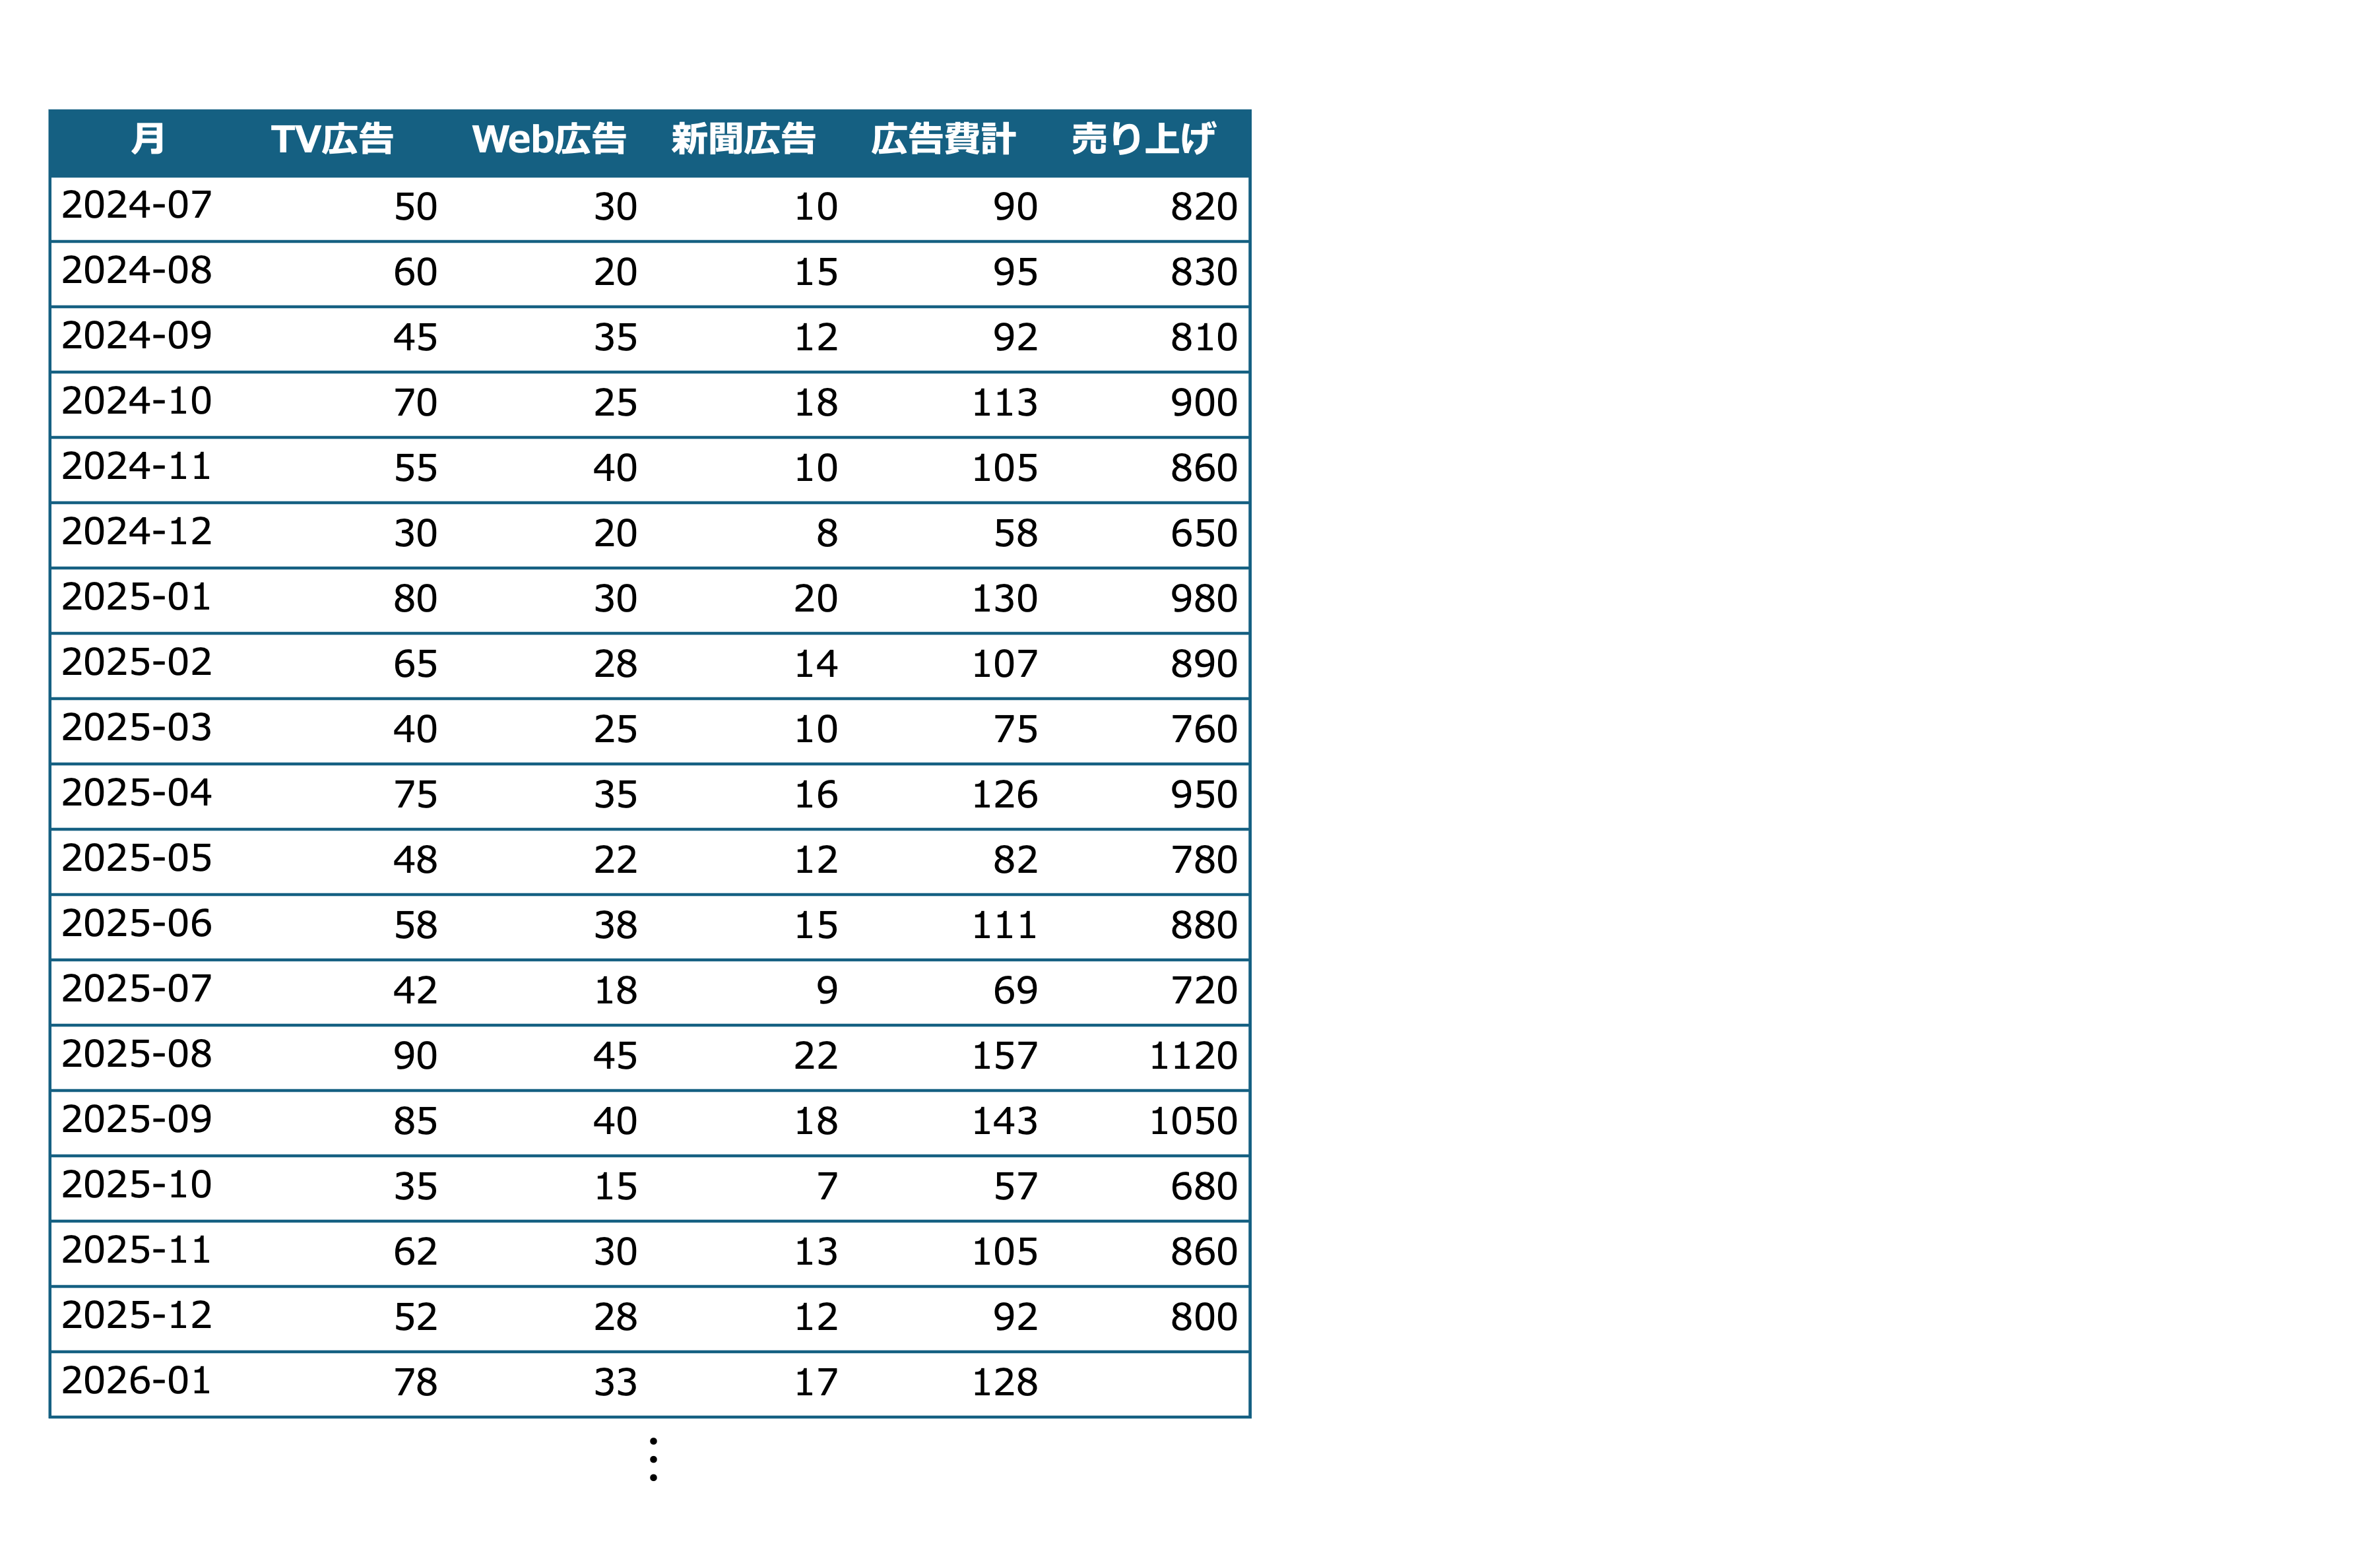
例えば、投入した広告費に対する月間売り上げを予測する場合を考えます。 単純に考えると、広告費が多ければ多いほど売り上げも多くなると予想できます。 このとき、予測したい月間売り上げを目的変数、投入した広告費(実績)を説明変数と呼びます。
もう少し詳しくモデル化したい場合は、どの分野に広告を出したか、という広告費の内訳をモデル化に加えることもできます。 例えば、テレビ、インターネット、新聞などへの広告費用です。 この場合は、分野ごとの広告費用をそれぞれ説明変数とし、目的変数である月間売り上げを予測します。
このように複数の説明変数を用いて目的変数を予測する場合を重回帰分析(multiple regression analysis)、 単一の説明変数から目的変数を予測する場合を単回帰分析(simple regression analysis)と呼びます。
また、一般的には、これまでの実績データが多ければ多いほど、より精度の高い予測が可能になります。 この「これまでの実績データ」は多くの場合、表形式でまとめられます。 このときの各行をサンプルと呼び、各列を特徴量(説明変数)と呼びます。
線形回帰(linear regression)#
教科書 p.377(Lesson 13.2)線形回帰(linear regression)は、教師あり学習の代表的な手法の一つであり、連続した値の予測を行う手法です。 1つのデータ\(x\)がもう一つのデータ\(y\)を説明するような関係である場合、 線形回帰では、\(y = \alpha x + \beta \) という関係によって\(y\)を説明していると考えます。
なお、説明変数が複数(\(m\)個)あった場合、 \(y = \alpha_1 x_1 + \alpha_2 x_2 + \cdots + \alpha_m x_m + \beta\) のような回帰式になります。 単一の説明変数から目的変数を導出することを単回帰分析、 複数の説明変数を用いて目的変数を予測することを重回帰分析と呼びます。
このような線形関係の式は、実測値と予測値の差の二乗和が最小になるように\(\alpha_i (i = 1, \ldots, m)\)と\(\beta\)を決め、式を求めます。 この手法を最小二乗法(least squares method)と呼びます。 求められた \(y = \sum_{i=1}^{m} \alpha_i x_i + \beta\)の式を回帰モデル(regression model)と呼び、 \(y\)を目的変数、\(x_i (i = 1, \ldots, m)\)を説明変数、\(\alpha_i\)を回帰係数(coefficient)、 \(\beta\)を切片(intercept)と呼びます。
線形回帰による教師あり学習の例#
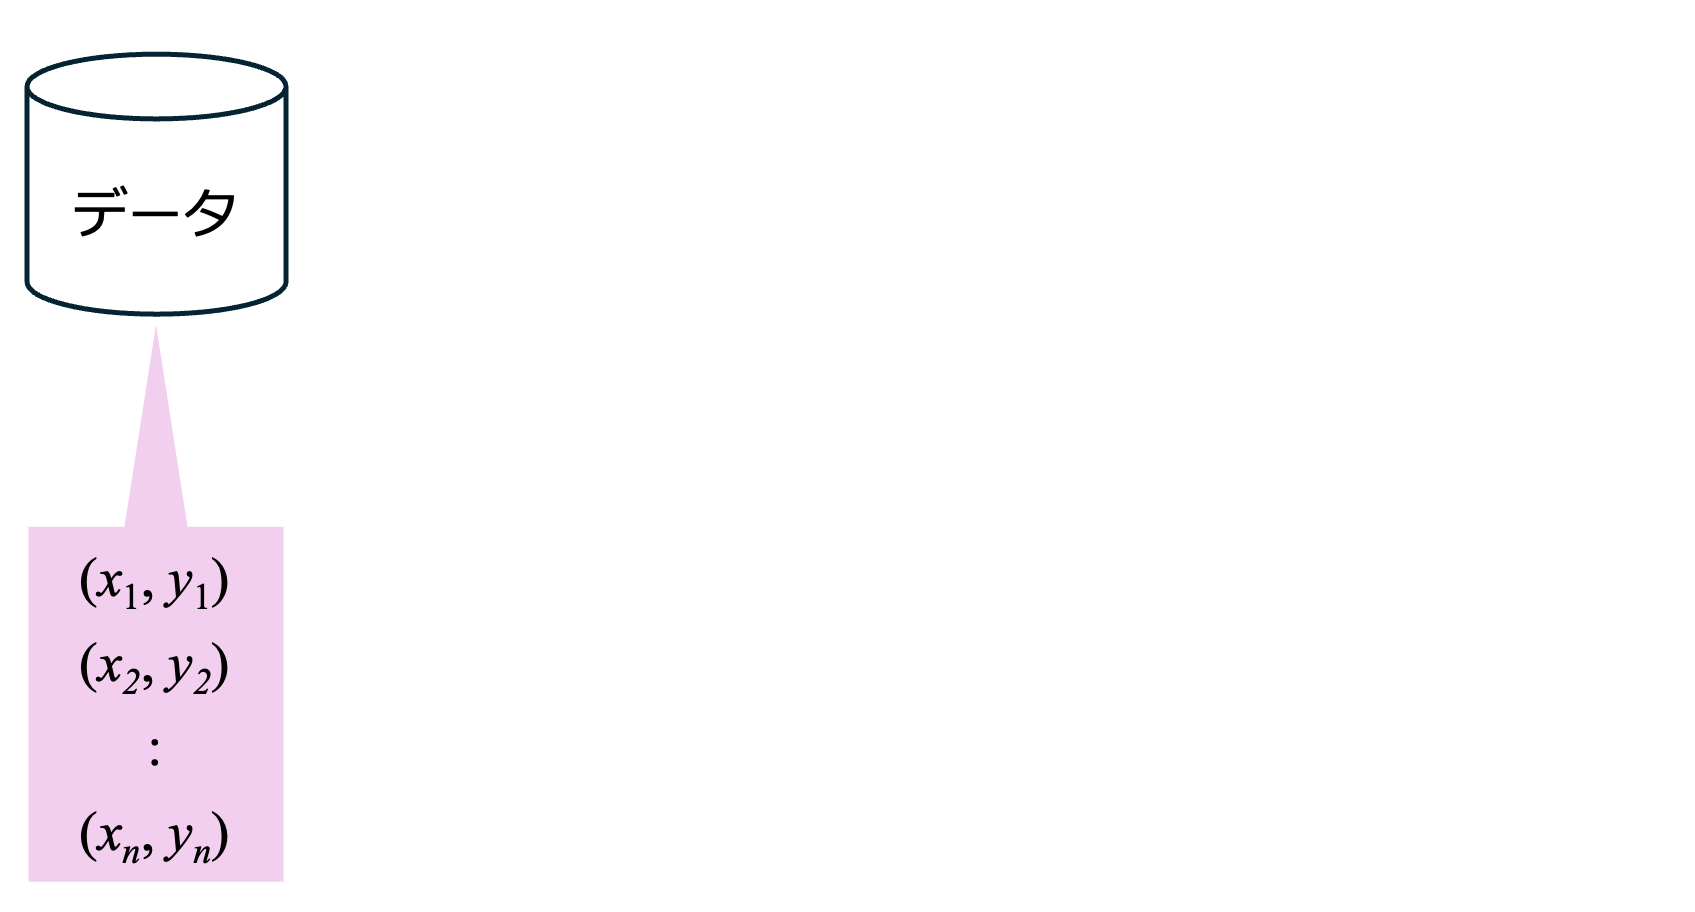
線形回帰などの教師あり学習による機械学習では、観測されたデータ \(x\)、\(y\)を、 まず学習データ(x_train, y_train)とテストデータ(x_test, y_test)の2つに分けておきます。
学習データは、モデルの導出に使うデータとし、テストデータは、モデルを使った予測のために用いるデータです。 モデルは、学習データ(x_train, y_train)から求めます。
モデルが求められたら、今度はテストデータ\(x\)(x_test)をモデルに当てはめて、\(y\)(y_pred)を求めます。 ここで求めた y_pred が予測値です。 なお、テストデータ\(y\)(y_test)が存在すれば、y_predとy_testの差を評価することで、モデルの精度を評価できます。 モデルの精度を評価する方法に、決定係数(coefficient of determination)や平均二乗誤差(mean square error)などがあります。
データを準備する。#
教科書 p.379(Lesson 13.2)Scikit-learn には、機械学習のためのデータを生成するモジュール datasets が用意されています。
ここでは、このモジュールを利用して、データを用意します。
>>> from sklearn import datasets
    # サンプル数 100、説明変数(n_features)の数: 1、ノイズ 30 でデータを生成する。
>>> x, y = datasets.make_regression(n_samples=100, n_features=1, noise=30)
    # 学習データ、テストデータを分割する関数をインポートする。
>>> from sklearn.model_selection import train_test_split
    # 学習データ、テストデータを分割する。学習データを70%に設定している。
>>> x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3)線形回帰を行う。#
教科書 p.381(Lesson 13.2)線形回帰を行うモジュールはlinear_modelであり、from sklearn import linear_modelでインポートします。
線形回帰を行うには、LinearRegressionクラスをインスタンス化し、fitメソッドで学習データを与えます。
>>> from sklearn import linear_model
    # 回帰分析を行うためのオブジェクトを作成する。
>>> model = linear_model.LinearRegression()
    # モデルを構築する(学習データをもとに学習する)。
>>> model.fit(x_train, y_train)
    # 傾き、切片を表示する。model.coef_ は説明変数が増えると配列の長さが増える。
    # 今回は説明変数が1つなので、model.coef_ は長さ1の配列。
>>> print(f"y = {model.coef_[0]} x + {model.intercept_}")
y = 71.68806792338619 x + -1.1209238100182013
    # x_test を用いて、yの予測値(y_pred)を求める。
>>> y_pred = model.predict(x_test)
>>> print(f"学習データに対するモデルの精度: {model.score(x_train, y_train)}")
0.8489204360720766
>>> print(f"テストデータに対するモデルの精度: {model.score(x_test, y_test)}")
0.7789948180721231結果を可視化する。#
結果を可視化するには、matplotlib.pylot を利用します。
>>> import matplotlib.pyplot as plt
>>> plt.scatter(x_train, y_train, label = "train")
>>> plt.scatter(x_test, y_test, label = "test")
>>> plt.plot(x_test, y_pred, color="magenta", label="prediction")
>>> plt.legend()
>>> plt.show()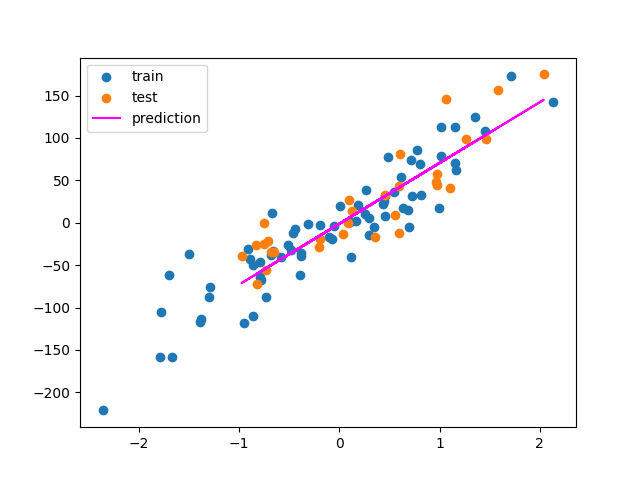
青が学習データ、オレンジがテストデータ、マゼンタが予測値(回帰直線)です。
linear_regression.py
上の例では、対話型インタプリタを用いて線形回帰を行いました。
上と同等の内容をスクリプト(linear_regression.py)として記述したものが以下の通りです。
from sklearn import datasets
# 学習データ、テストデータを分割する関数をインポートする。
from sklearn.model_selection import train_test_split
from sklearn import linear_model

# サンプル数 100、説明変数(n_features)の数: 1、ノイズ 30 でデータを生成する。
x, y = datasets.make_regression(n_samples=100, n_features=1, noise=30)
# 学習データ、テストデータを分割する。学習データを70%に設定している。
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3)

# 回帰分析を行うためのオブジェクトを作成する。
model = linear_model.LinearRegression()
# モデルを構築する(学習データをもとに学習する)。
model.fit(x_train, y_train)

# x_test を用いて、yの予測値(y_pred)を求める。
y_pred = model.predict(x_test)

# 傾き、切片を表示する。model.coef_ は説明変数が増えると配列の長さが増える。
# 今回は説明変数が1つなので、model.coef_ は長さ1の配列。
print(f"y = {model.coef_[0]} x + {model.intercept_}")
print(f"学習データに対するモデルの精度: {model.score(x_train, y_train)}")
print(f"テストデータに対するモデルの精度: {model.score(x_test, y_test)}")

# 以下、可視化のためのコード
import matplotlib.pyplot as plt

plt.scatter(x_train, y_train, label = "train")
plt.scatter(x_test, y_test, label = "test")
plt.plot(x_test, y_pred, color="magenta", label="prediction")
plt.legend()
plt.show()
例題09-1: 最終成績を予測する。#
課題08-2 成績の統計 で扱った成績データを用いて、最終成績を予測するプログラムを作成し、予測モデルの精度を評価してみましょう。
predict_score.py として保存してください。
求めた回帰モデルの評価には、テストデータを回帰モデルに適用して得られた予測値と、テストデータの y_test とを比較します。
評価方法は、sklearn.metrics モジュールに用意されている関数を利用します(以下の計算式を用いて自分で計算もできます)。
- 平均絶対誤差 (MAE; Mean Absolute Error)
- 実際の値と予測値の差の絶対値を平均したものです。この値が小さいほど精度が高いと言えます。
sklearn.metrics.mean_absolute_error関数で求められます。- \(\mathrm{MAE}(y, p) = \frac{1}{n}\sum_{i = 1}^{n} |y_i - p_i| \)
- 平均二乗誤差 (MSE; Mean Squared Error)
- 実際の値と予測値の差の二乗を平均したものです。MAEに比べて、誤差が大きいときに値が大きくなります。
sklearn.metrics.mean_squared_error関数で求められます。- \(\mathrm{MSE}(y, p) = \frac{1}{n}\sum_{i = 1}^{n} (y_i - p_i)^2 \)
- 二乗平均平方根誤差 (RMSE; Root Mean Squared Error)
- MSE の平方根です。
sklearn.metrics.mean_squared_error関数の結果をnp.sqrtで関数に与えることで求めます。- \(\mathrm{RMSE}(y, p) = \sqrt{\frac{1}{n}\sum_{i = 1}^{n} (y_i - p_i)^2} \)
- 決定係数 (R2; R-squared, coefficient of determination)
- 寄与率とも呼ばれ、モデルの当てはまりの良さを示す指標であり、最も当てはまりの良い場合 1.0 となり、当てはまりが悪いとマイナスの値になることもあります。
sklearn.metrics.r2_score関数で求められます。- \(R^2(y, p) = 1 - \frac{\sum_{i=1}^{n} (y_i - p_i)^2}{\sum_{i=1}^{n} (y_i - \bar{y})^2} \)
- 分子は予測の誤差の二乗和、分母は実測値のばらつき(実測値をすべてその平均で予測したときの誤差の二乗和)です。
- 回帰モデルの
scoreメソッドが返す値も、この決定係数です。
- \(R^2(y, p) = 1 - \frac{\sum_{i=1}^{n} (y_i - p_i)^2}{\sum_{i=1}^{n} (y_i - \bar{y})^2} \)
以上の式で、\(n\) はテストデータの個数、\(y_i\) は \(i\) 番目のテストデータの実測値(y_test)、\(p_i\) はその予測値(y_pred)、\(\bar{y}\) は実測値の平均値です。
from sklearn.model_selection import train_test_split # 学習データとテストデータを分割する。
from sklearn import linear_model
from sklearn import metrics
import numpy as np
import sys

def read_csv(filename):
    x = []
    y = []
    with open(filename, "r") as f:
        f.readline()    # ヘッダ行を読み飛ばす。
        for line in f:
            cols = line.strip().split(",") # 改行を削除し、コンマで分割する。
            y.append(float(cols[1]))   # 目的変数(最終成績)を追加する。
            # 説明変数を追加する。
            x.append([float(cols[2]), float(cols[3]), float(cols[4]),\
                float(cols[5]), float(cols[6])])
    return x, y

x, y = read_csv(sys.argv[1]) # ファイル名はコマンドライン引数で指定する。
# 学習データとテストデータに分ける。
# random_state を指定すると、実行のたびに同じ分け方になる(指定しなければ毎回異なる)。
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3, random_state=2)
# モデルのインスタンスを構築する。
model = linear_model.LinearRegression()
# モデルを構築する(学習データをもとに学習する)。
model.fit(x_train, y_train)
# 予測する。
y_pred = model.predict(x_test)

print(f"回帰モデル y = {model.coef_[0]} x1 + {model.coef_[1]} x2 + {model.coef_[2]} x3 + {model.coef_[3]} x4 + {model.coef_[4]} x5 + {model.intercept_}")
print(f"学習データに対するモデルの精度: {model.score(x_train, y_train)}")
print(f"テストデータに対するモデルの精度: {model.score(x_test, y_test)}")

print(f"MAE  {metrics.mean_absolute_error(y_test, y_pred)}")
print(f"MSE  {metrics.mean_squared_error(y_test, y_pred)}")
print(f"RMSE {np.sqrt(metrics.mean_squared_error(y_test, y_pred))}")
print(f"R2 {metrics.r2_score(y_test, y_pred)}")実行結果#
テストデータと学習データはシャッフルされた後に分割されます。
random_state=2 を指定しているので以下と同じ結果になりますが、random_state を外すと分け方が毎回変わり、値も変わります。
$ python3 predict_score.py score.csv
回帰モデル y = 0.45122335034956657 x1 + 0.4491420300015201 x2 + 0.10064907265760872 x3 + 0.049214568383591076 x4 + 0.050294638532865726 x5 + 0.4036016237510438
学習データに対するモデルの精度: 0.9998846785623169
テストデータに対するモデルの精度: 0.9998491006485888
MAE  0.26996431365406504  # 実測値と予測値の差の絶対値の平均。
MSE  0.09606306529534538 # 実測値と予測値の差の二乗の平均。
RMSE 0.30994042217068973 # MSE の平方根
R2   0.9998491006485888  # 決定係数。model.score と同じ値。
0〜100の範囲の最終成績の予測値が、実際の値との差で 0.3程度であるため、このモデルはある程度精度が高いと言えます。
データクレンジング(Data Cleansing)
機械学習の各アルゴリズムには、様々なパラメータが存在します。 予測が期待通りの結果にならない場合、このようなパラメータを調整することで、精度の向上が期待できます。
しかしその前に、データのクレンジング(データの洗浄)を行う方が、精度の大きな向上が期待できます。 データのクレンジングとは、重複や誤記、抜けや外れ値など、学習の邪魔になるようなデータが含まれていないかを確認し、削除したり、可能であれば修正することです。 これが、学習の邪魔になるデータを除去することになり、より良い予測につながります。
パラメータの調整による精度向上は、データクレンジングを行った後に行うことをお勧めします。 なぜなら、アルゴリズムの詳細を知らない状態で、闇雲にパラメータを調整しても、当てずっぽうにしかならず、逆に精度を下げることもあるからです。 それよりも、自身がよく知っているはずのデータの中で、学習に値するデータのみを厳選した方がより良い精度向上につながることが多いです。