課題10-1 特徴量の尺度とクラスタリング#
\(k\)平均法は、データ点同士の距離をもとにクラスタを作ります。
そのため、ある特徴量だけ値の幅(尺度)が大きいと、距離がその特徴量でほぼ決まってしまい、他の特徴量がクラスタリングに効かなくなります。
このことを小さな2次元データで確認するプログラム scale_clustering.py を作成してください。
datasets.make_blobsで、中心が[0, 0]、[5, 5]、[10, 0]の3つのかたまりからなる2次元データdataを生成してください(n_samples=300、cluster_std=1.0、random_state=0)。dataのy列(1列目)だけを100倍したデータdata2を作ってください(data2 = data * [1, 100])。単位が変わっただけで、データの「かたまり」の形は変わっていないことに注意してください。data2を標準化したデータdata3を作ってください(下記のStandardScalerを参照)。data、data2、data3のそれぞれに対してクラスタ数3の\(k\)平均法を行い、例題10-1と同様にクラスタ番号で色分けした散布図を3つ並べて描画してください。クラスタ中心は×印で描いてください。
標準化(standardization) とは、特徴量ごとに平均を0、標準偏差を1に揃える変換です。
sklearn.preprocessing.StandardScaler で行えます。
from sklearn import preprocessing
scaler = preprocessing.StandardScaler() # 標準化を行うオブジェクトを生成する。
data3 = scaler.fit_transform(data2)     # data2 の各列の平均と標準偏差を求め(fit)、標準化する(transform)。
from sklearn import datasets
from sklearn import cluster
from sklearn import preprocessing
import matplotlib.pyplot as plt
data, _ = datasets.make_blobs(n_samples=300, centers=[[0, 0], [5, 5], [10, 0]], cluster_std=1.0, random_state=0)
data2 = data * [1, 100] # y 列だけを 100 倍する。
data3 = # data2 を標準化する。
fig, axes = plt.subplots(1, 3, figsize=(15, 4.5)) # 横に 3 つ並べる。axes[0], axes[1], axes[2] がそれぞれの描画先。
for ax, d, title in zip(axes, [data, data2, data3], ["(1) original", "(2) y x 100", "(3) (2) standardized"]):
model = # kMeans を行うオブジェクトを生成する(クラスタ数は 3)。
# d を対象にクラスタリングを行う。
ax.scatter(...) # d の 0 列目、1 列目で散布図を描画し、クラスタ番号で色分けする。
ax.scatter(model.cluster_centers_[:, 0], model.cluster_centers_[:, 1], marker="x", c="red")
ax.set_title(title)
plt.show()実行結果の例#
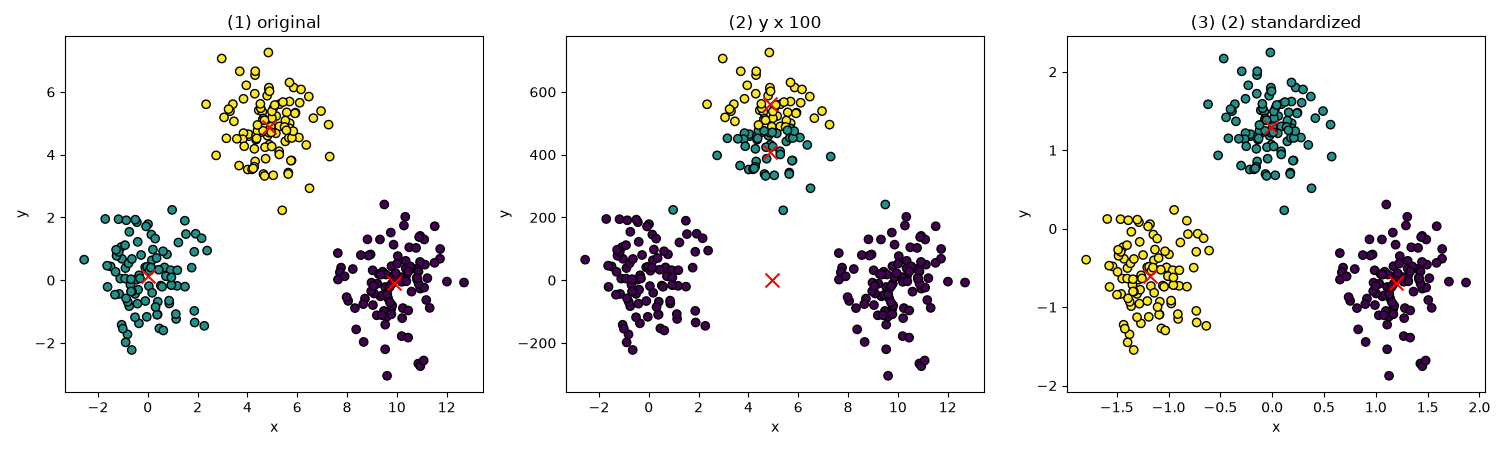
(2) では、上のかたまりが2つに割られ、下の2つのかたまりが1つにまとめられています。 なぜ (1) と (2) で結果が変わるのか(\(x\)方向の差と、100倍された\(y\)方向の差を比べてみてください)、 また、なぜ (3) では (1) と同じ結果に戻るのかをコメントに記してください。
課題10-2 発展課題(任意) ワインの特徴によるクラスタリング#
この課題は任意です。提出は必須ではなく、取り組まなくても不利にはなりません。 課題10-1 で確認した尺度の影響が、実際のデータでどう現れるかを確かめます。
scikit-learn に付属するワインのデータセット(Wine recognition dataset)は、
イタリアの同じ地域で作られた 3つの異なる品種のワイン 178本について、13種類の化学成分を測定したものです。
wine.target には各ワインの品種(0、1、2)が入っています。
これは種類を区別するためのラベルであり、品質の優劣や順位を表すものではありません。
同様に、クラスタリングで得られるクラスタ番号(model.labels_)も区別のための番号にすぎず、番号の大小に意味はありません。実行するたびに番号の割り当てが変わることもあります。
以下の手順でクラスタリングを行い、散布図を描画するプログラム wine_clustering.py を作成してください。
そして、結果に対する考察をプログラム中のコメントに記してください。
- データは、
wine = sklearn.datasets.load_wine()を使って読み込んでください。 - 学習に使う特徴量 は、各ワインの次の13の変数(
wine.data)すべてです。それぞれの変数の意味は次の通りです。wine.feature_namesからも確認できます。- alcohol(アルコール度数)
- malic_acid(リンゴ酸)
- ash(灰分(かいぶん))
- alcalinity_of_ash(灰分のアルカリ度)
- magnesium(マグネシウム)
- total_phenols(全フェノール含量)
- flavanoids(フラボノイド)
- nonflavanoid_phenols(非フラボノイドフェノール)
- proanthocyanins(プロアントシアニン)
- color_intensity(色の濃さ)
- hue(色相)
- od280/od315_of_diluted_wines(希釈ワイン溶液のOD280/OD315(=280nmと315nmの吸光度の比))
- ChatGPTの解説
- ワイン分析における OD280/OD315 は、ワインを特定の波長(280nmと315nm)で測定した際の吸光度(Optical Density)の比率を指します。一般的には、主にポリフェノール類(特にフラボノイドなど)の含有量や性質を把握する指標として用いられます。
- 280nm付近の吸収: ベンゼン環など芳香族化合物を含む物質(ポリフェノール、タンパク質など)がよく吸収する波長帯
- 315nm付近の吸収: 一部のフェノール類や関連化合物がよく吸収する波長帯
- この2つの吸光度を比率で捉えることで、ワイン中に含まれるフェノール類の量や種類に関する情報(渋味・苦味の強さ、熟成によるフェノール変化の度合いなど)をおおまかに推し量ることができます。ワイン研究では、総ポリフェノール濃度などを推定したり、熟成の評価指標として使われたりすることが多いです。
- ワイン分析における OD280/OD315 は、ワインを特定の波長(280nmと315nm)で測定した際の吸光度(Optical Density)の比率を指します。一般的には、主にポリフェノール類(特にフラボノイドなど)の含有量や性質を把握する指標として用いられます。
- ChatGPTの解説
- proline(プロリン)
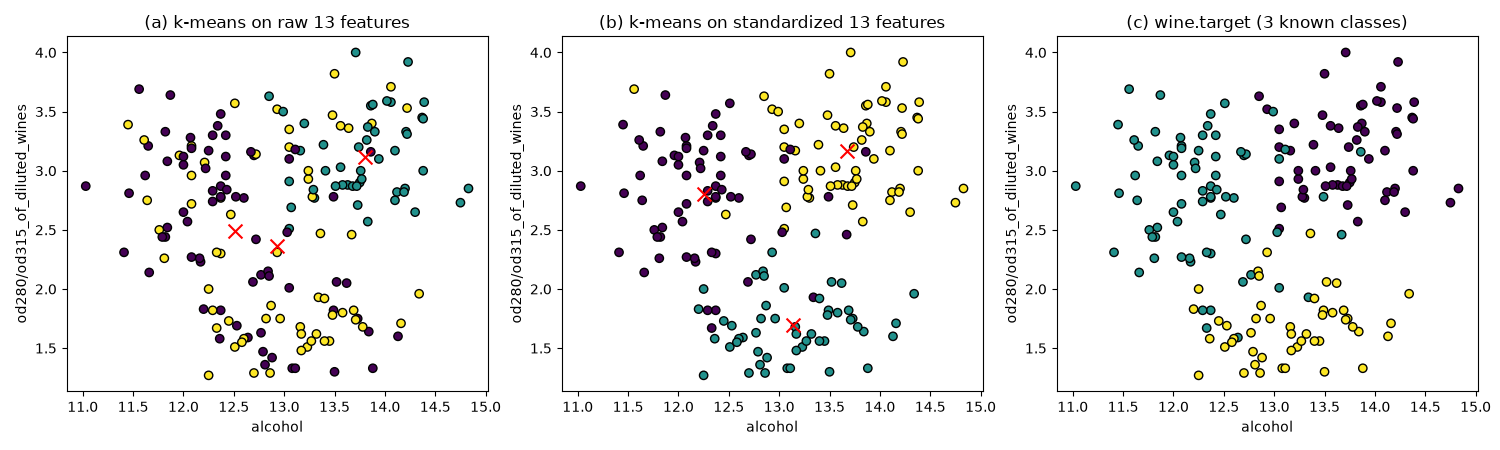
- 描画に使う列 は、alcohol(0列目)と od280/od315_of_diluted_wines(11列目)の2列です。 13次元でクラスタリングした結果を、この2列に投影して眺めているだけであることに注意してください。2列だけでクラスタリングするわけではありません。
- 次の3つの散布図を並べて描画してください。横軸・縦軸はいずれも
wine.dataの0列目と11列目(元の単位)です。- (a)
wine.dataをそのまま用いて、クラスタ数3の\(k\)平均法でクラスタリングし、クラスタ番号で色分けした散布図。クラスタ中心は×印で描いてください。 - (b)
wine.dataをStandardScalerで標準化してから、クラスタ数3の\(k\)平均法でクラスタリングし、クラスタ番号で色分けした散布図。 クラスタ中心(model.cluster_centers_)は標準化後の座標なので、scaler.inverse_transformで元の単位に戻してから描いてください。 - (c) 比較のため、
wine.target(品種)で色分けした散布図。クラスタリングにはwine.targetを使いません。
- (a)
from sklearn import datasets
from sklearn import cluster
from sklearn import preprocessing
import matplotlib.pyplot as plt

wine = datasets.load_wine() # ワインのデータセットをロードする。
X = wine.data               # 学習に使う 13 個の特徴量。
xi, yi = 0, 11              # 描画に使う 2 列(alcohol, od280/od315_of_diluted_wines)。

# (a) 標準化せずにクラスタリングする。
model_raw = # kMeans を行うオブジェクトを生成する(クラスタ数は 3)。
# X を対象にクラスタリングを行う。

# (b) 標準化してからクラスタリングする。
scaler = preprocessing.StandardScaler()
X_std = # X を標準化する。
model_std = # kMeans を行うオブジェクトを生成する(クラスタ数は 3)。
# X_std を対象にクラスタリングを行う。
centers_std = scaler.inverse_transform(model_std.cluster_centers_) # クラスタ中心を元の単位に戻す。

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))
axes[0].scatter(...) # X の xi 列目、yi 列目で散布図を描画し、model_raw のクラスタ番号で色分けする。
axes[0].scatter(model_raw.cluster_centers_[:, xi], model_raw.cluster_centers_[:, yi], marker="x", c="red")
axes[1].scatter(...) # X の xi 列目、yi 列目で散布図を描画し、model_std のクラスタ番号で色分けする。
axes[1].scatter(centers_std[:, xi], centers_std[:, yi], marker="x", c="red")
axes[2].scatter(...) # X の xi 列目、yi 列目で散布図を描画し、wine.target で色分けする。
for ax, title in zip(axes, ["(a) raw", "(b) standardized", "(c) wine.target"]):
    ax.set_title(title)
    ax.set_xlabel(wine.feature_names[xi])
    ax.set_ylabel(wine.feature_names[yi])
plt.show()実行結果の例#
考察#
以下の点について、コメントに考察を記してください。 特定の見た目の散布図を「正解」とはしません。特徴量の尺度、13次元から2次元への投影、クラスタ数などの根拠を挙げて説明できているかを評価します。
- (a) と (b) でクラスタの分かれ方が大きく違うのはなぜでしょうか。
各特徴量の値の範囲を
wine.data.min(axis=0)、wine.data.max(axis=0)、wine.data.std(axis=0)などで確認し、(a) ではどの特徴量が距離を支配しているかを調べてください。 - 散布図上で重なって見える点同士も、描いていない残り11次元では離れているかもしれません。 「2次元の散布図でまとまって見えない」というだけで、クラスタリングが失敗したと言えるでしょうか。
- (b) と (c) を見比べて、クラスタと品種はどの程度対応しているでしょうか。また、対応していても色(クラスタ番号と品種の番号)が一致しないのはなぜでしょうか。
- (余裕があれば)クラスタ数を2や4にすると、結果はどう変わるでしょうか。