クラスタリング(Clustering)#
教科書 p.386(Lesson 13.3)クラスタリングは、教師なし学習の代表的な手法の一つであり、与えられたデータのみから学習して、 グループ分け(クラスタ)の基準を見つけ出すものです。
最もシンプルなクラスタリングの手法に \(k\)平均法(\(k\)-means法)があります。 データを\(k\)個のクラスタに分類するため、各クラスタ内の中心と各データとの差を最小化するようにデータの中心を更新していきます。 以下の手順でクラスタリングを行います。
- 各データの初期クラスタを決める。
- 各クラスタに属するデータの平均(中心)を求める。
- 各データとその他のクラスタの中心との距離を計算する。
- 各データを最も近い中心を持つクラスタに再分類する。
このうち、2〜4を繰り返すことで、クラスタリングを行います。
例題10-1 \(k\)平均法による教師なし学習の例#
データを生成する。#
SciKit-learn には、機械学習のためのデータを生成するモジュール datasets が用意されています。
このモジュールを利用して、クラスタリングのためのデータを用意します。
    # データ生成のためのモジュールをインポートする。
>>> from sklearn import datasets
    # サンプル数 500、特徴量(n_features)の数: 2、クラスタ数 5 でデータを生成する。
>>> data, labels = datasets.make_blobs(n_samples=500, n_features=2, centers=5)クラスタリングを行う。#
クラスタリングを行うモジュールは cluster であり、from sklearn import cluster でインポートします。
>>> from sklearn import cluster             # クラスタリングを行うモジュールをインポートする。
>>> model = cluster.KMeans(n_clusters=5) # k平均法を行うオブジェクトをクラスタ数を指定して生成する。
>>> model.fit(data)                      # クラスタリングを行う。
KMeans(n_clusters=5)
>>> print(model.labels_)                 # 各データのクラスタ番号を表示する。
[1 3 2 4 2 3 3 3 2 2 3 3 4 1 2 0 1 2 1 3 4 1 2 1 4 4 0 0 2 3 3 0 0 0 4 4 4
 2 3 2 1 3 0 0 3 3 3 2 1 1 3 4 0 4 2 1 3 1 3 0 3 2 3 3 4 1 2 1 2 3 1 3 3 2
 2 3 4 2 0 1 4 3 0 4 4 2 4 1 1 4 2 4 0 1 3 0 0 1 1 1 2 4 4 2 1 0 3 2 0 0 0
 4 0 4 1 2 0 0 0 0 4 2 1 0 3 1 1 0 4 3 0 2 1 3 1 0 4 1 3 1 3 4 1 2 4 1 3 2
 0 2 2 3 3 4 3 2 4 2 0 2 3 2 2 0 4 3 0 3 0 1 0 1 0 0 0 0 1 3 3 1 1 4 2 2 2
 1 2 4 2 1 0 2 4 1 2 2 0 3 4 0 2 2 0 2 4 1 3 0 1 4 4 1 4 0 0 4 4 2 3 4 0 0
 1 0 4 1 3 2 2 2 1 4 1 1 3 1 3 4 3 4 2 2 0 0 1 1 4 3 3 2 2 2 0 3 3 4 2 2 2
 2 4 1 1 1 2 1 2 1 2 0 2 4 1 1 3 0 4 3 0 3 1 3 0 4 3 2 4 0 3 4 3 3 2 1 1 0
 1 0 2 0 4 1 3 3 0 3 2 3 3 4 4 4 0 3 0 0 2 3 2 4 2 3 2 2 1 4 1 3 2 4 1 1 2
 0 4 2 0 3 2 1 2 3 3 1 2 0 1 4 1 0 1 0 2 0 4 1 0 4 3 1 1 4 2 1 4 4 2 0 4 1
 3 1 0 2 1 4 3 0 0 4 4 1 1 1 3 4 2 3 2 3 2 3 3 0 3 4 3 4 3 1 0 2 1 2 3 4 0
 0 1 4 0 4 2 0 1 0 4 3 4 3 2 0 4 1 0 4 1 4 0 2 0 0 3 4 4 3 0 1 3 4 3 3 4 2
 1 4 2 4 1 4 4 4 2 3 4 1 3 2 1 1 0 4 0 0 3 4 0 0 2 3 3 1 0 1 3 2 3 0 4 4 4
 4 1 2 4 4 4 1 3 0 2 1 3 0 2 2 3 3 0 4]
>>> print(model.cluster_centers_)        # 各クラスタの中心を表示する。
[[ 2.06171457 -2.37977162]
 [ 4.39544508  5.83214549]
 [ 7.38048687 -1.29138686]
 [-0.66801221 -1.33974494]
[ 4.65033744 2.94827448]]結果を可視化する。#
matplotlib.pyplot を利用して、クラスタリングの結果を可視化します。
>>> import matplotlib.pyplot as plt         # グラフ描画のためのモジュールをインポートする。
>>> plt.scatter(data[:, 0], data[:, 1], marker="o", c=model.labels_, edgecolor="k")
>>> plt.scatter(model.cluster_centers_[:, 0], model.cluster_centers_[:, 1], marker="x", c="red")
>>> plt.show()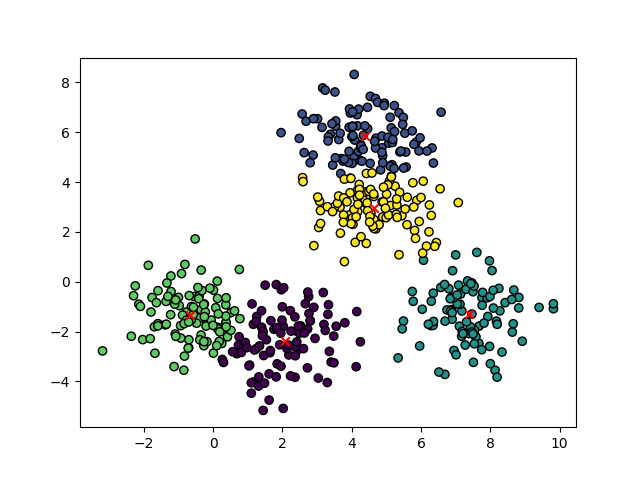
data[:, 0]は全ての行の1列目(0番目の列)のみを取得し、data[:, 1]は全ての行の2列目(1番目の列)のみを取得します。
marker="o"はデータ点を円で表示し、c=model.labels_は各データ点のクラスタ番号に応じて色を変えます。
edgecolor="k"はデータ点の境界線を黒色で表示します。
marker="x"はクラスタの中心を×印で表示し、c="red"はクラスタの中心を赤色で表示します。
データは乱数で生成されていますので、実行例の通りにはなりません。
kmeans_example.py
上の例では、対話型インタプリタを用いてクラスタリングを行いました。
上と同等の内容をスクリプト(kmeans_example.py)として記述したものが以下の通りです。
from sklearn import datasets    # データ生成のためのモジュールをインポートする。
from sklearn import cluster     # クラスタリングを行うモジュールをインポートする。
import matplotlib.pyplot as plt # グラフ描画のためのモジュールをインポートする。

# サンプル数 500、特徴量(n_features)の数: 2、クラスタ数 5 でデータを生成する。
data, labels = datasets.make_blobs(n_samples=500, n_features=2, centers=5)

# k平均法を行うオブジェクトをクラスタ数を指定して生成する。
model = cluster.KMeans(n_clusters=5)
model.fit(data) # クラスタリングを行う。

plt.scatter(data[:, 0], data[:, 1], marker="o", c=model.labels_, edgecolor="k")
plt.scatter(model.cluster_centers_[:, 0], model.cluster_centers_[:, 1], marker="x", c="red")
plt.show()
例題10-2 階層的クラスタリングによる教師なし学習の例#
クラスタリングを行う。#
先ほどと同様に datasets モジュールを利用してデータを生成して、階層的クラスタリングを行いましょう。
階層的クラスタリングは、cluster モジュールの AgglomerativeClustering クラスを利用します。
階層的クラスタリングでは、各要素間の距離を metric で指定し、クラスタ間の距離を linkage で指定します。
metirc、linkageで指定できる値は次の通りです。
metric | 説明 |
|---|---|
euclidean | ユークリッド距離(l2ノルム)。デフォルト。 |
manhattan | マンハッタン距離。碁盤の目状の道を進む時の距離の計算方法。l1ノルム。 |
cosine | コサイン類似度。 |
precomputed | 事前に距離行列を計算しておき、fitメソッドに渡す必要がある。 |
linkage | 説明 |
|---|---|
ward | ウォード法。デフォルト。 |
average | 群平均法。 |
complete | 最長距離法。 |
single | 最短距離法。 |
    # データ生成のためのモジュールをインポートする。
>>> from sklearn import datasets
    # サンプル数 500、特徴量(n_features)の数: 2、クラスタ数 3 でデータを生成する。
>>> data, labels = datasets.make_blobs(n_samples=500, n_features=2, centers=5)
>>> from sklearn import cluster             # クラスタリングを行うモジュールをインポートする。
>>> model = cluster.AgglomerativeClustering(n_clusters=5, linkage="ward", metric="euclidean")
    # ボトムアップアプローチで階層的クラスタリングを行うオブジェクト(クラスタ間の距離はウォード法、
    # 要素間の距離はユークリッド距離)を生成する。
>>> model.fit(data)                      # クラスタリングを行う。
データを生成する部分は例題14-1と同じです。
作成するモデルが、cluster.AgglomerativeClustering であることと、linkage と metric の指定が異なります。
結果を可視化する。#
matplotlib.pyplot を利用して、クラスタリングの結果を可視化します。
>>> import matplotlib.pyplot as plt # グラフ描画のためのモジュールをインポートする。
# クラスタリング結果を描画する。
>>> plt.scatter(data[:, 0], data[:, 1], marker="o", c=model.labels_, edgecolor="k")
>>> plt.show()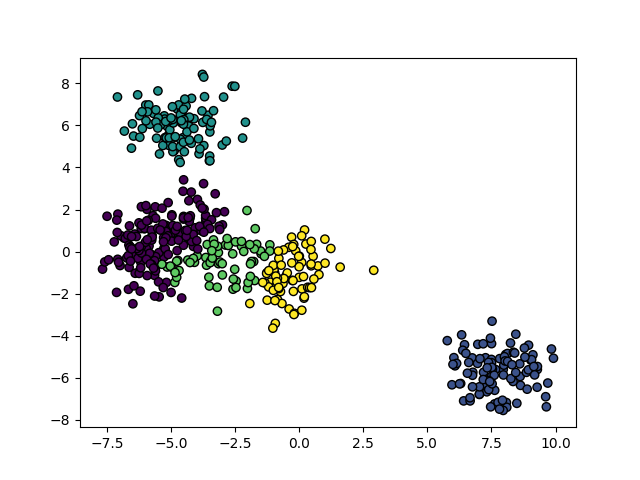
デンドログラム(樹形図; Dendrogram)#
階層的クラスタリングでは、どのような過程でクラスタリングが行われたかを可視化することもできます。 その可視化結果はデンドログラム(樹形図; Dendrogram)と呼ばれるグラフで表現されます。 デンドログラムを表示するには、以下の手順で行います。
- まず、
plot_dendrogram関数を用意します。 以下のplot_dendrogram関数は、Scikit-learn のページよりコピペしています。 - 次にクラスタリングを行った(
modelオブジェクトのfitメソッドを呼び出した)オブジェクトを準備します。 ただし、全ての要素間の距離を計測する必要があるため、n_clusters=None、かつdistance_threshold=0として呼び出す必要があります。 - 最後に、
plot_dendrogram関数を呼び出してデンドログラムを表示します。
# デンドログラムを表示する。
from scipy.cluster.hierarchy import dendrogram
import numpy as np

# デンドログラム表示関数(Scikit-learnのページよりコピペ)
# https://scikit-learn.org/stable/auto_examples/cluster/plot_agglomerative_dendrogram.html
def plot_dendrogram(model, **kwargs):
    # Create linkage matrix and then plot the dendrogram

    # create the counts of samples under each node
    counts = np.zeros(model.children_.shape[0])
    n_samples = len(model.labels_)
    for i, merge in enumerate(model.children_):
        current_count = 0
        for child_idx in merge:
            if child_idx < n_samples:
                current_count += 1  # leaf node
            else:
                current_count += counts[child_idx - n_samples]
        counts[i] = current_count

    linkage_matrix = np.column_stack(
        [model.children_, model.distances_, counts]
    ).astype(float)

    # Plot the corresponding dendrogram
    dendrogram(linkage_matrix, **kwargs)

model2 = cluster.AgglomerativeClustering(metric='euclidean',
                                linkage='ward',
                                distance_threshold=0,
                                n_clusters=None)
model2.fit(data)
plot_dendrogram(model2, truncate_mode='lastp', p=15)
plt.show()
上記のコードを先ほどまでのスクリプトの後に追加して実行すると、デンドログラムが表示されます。
全てのクラスタを表示すると、膨大なデータで見にくくなるため、
plot_dendrogram関数に渡す truncate_modeはデンドログラムの省略モードを指定します。
lastp だと最後の p クラスタだけを表示します。
上記の例だと、15クラスタまでを表示し、x軸のラベルはそのクラスタの要素数を表しています。
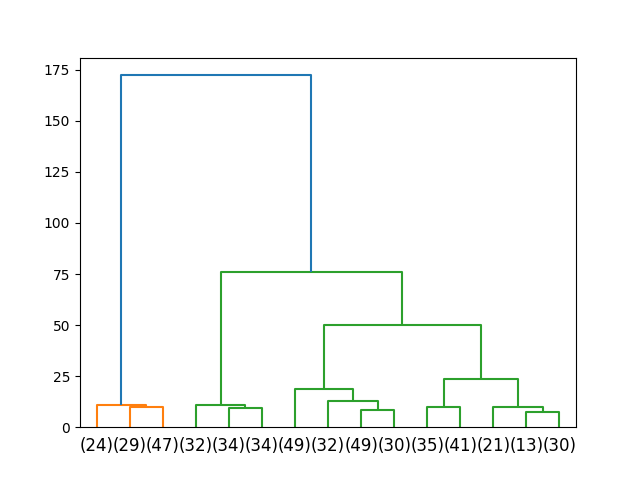
デンドログラムを見ると、逐次的にクラスタがまとめられていく様子がわかります。 縦軸はクラスタ間の距離を表し、つながったところで、クラスタが結合されたことを示しています。 そのように順に上に向かってクラスタが結合されていく様子がわかるのがデンドログラムです。