次元削減(Dimensionality Reduction)#
機械学習の際、データの次元が大きいと、計算量が膨大になることがあります。 そこで、教師なし学習で、計算に利用する変数を\(m\)個に減らす次元削減(Dimensionality Reduction)が行われます。 次元削減では、主成分分析(PCA; Principal Component Analysis)がよく用いられます。
また、3次元より大きな次元のデータだと、可視化も難しくなります。 次元を削減することで、データを3次元以下に縮退させて、可視化できるようになります。
#
Scikit-learn には、次元削減のための PCA クラスが用意されています。 これを用いて、アヤメ(IRIS)のデータを可視化してみましょう。 アヤメのデータは、scikit-learn に含まれており、ガクの長さ(sepal length)、ガクの幅(sepal width)、花弁の長さ(peral length)、花弁の幅(petal width)の4つのデータから、アヤメの種類(ヒオウギアヤメ(setosa), ブルーフラッグ(versicolor), バージニカ(virginica))を予測できます。
ただし、元のデータは4次元ですので、グラフ表示できません。
全体の雰囲気を見るために、2次元までに次元を削減して可視化してみましょう。
以下のコードを pca_example.py として保存し、実行してください。
from sklearn import datasets
from sklearn import decomposition

iris = datasets.load_iris() # アヤメのデータを読み込む。
x = iris.data # 説明変数(特徴量)を取得する。

pca = decomposition.PCA(n_components=2) # 主成分分析を行うオブジェクトを生成する。
pca.fit(x)               # 主成分分析を行う。
x_pca = pca.transform(x) # 主成分分析を行った結果を取得する。

import matplotlib.pyplot as plt
plt.scatter(x_pca[:, 0], x_pca[:, 1], c=iris.target)
plt.show()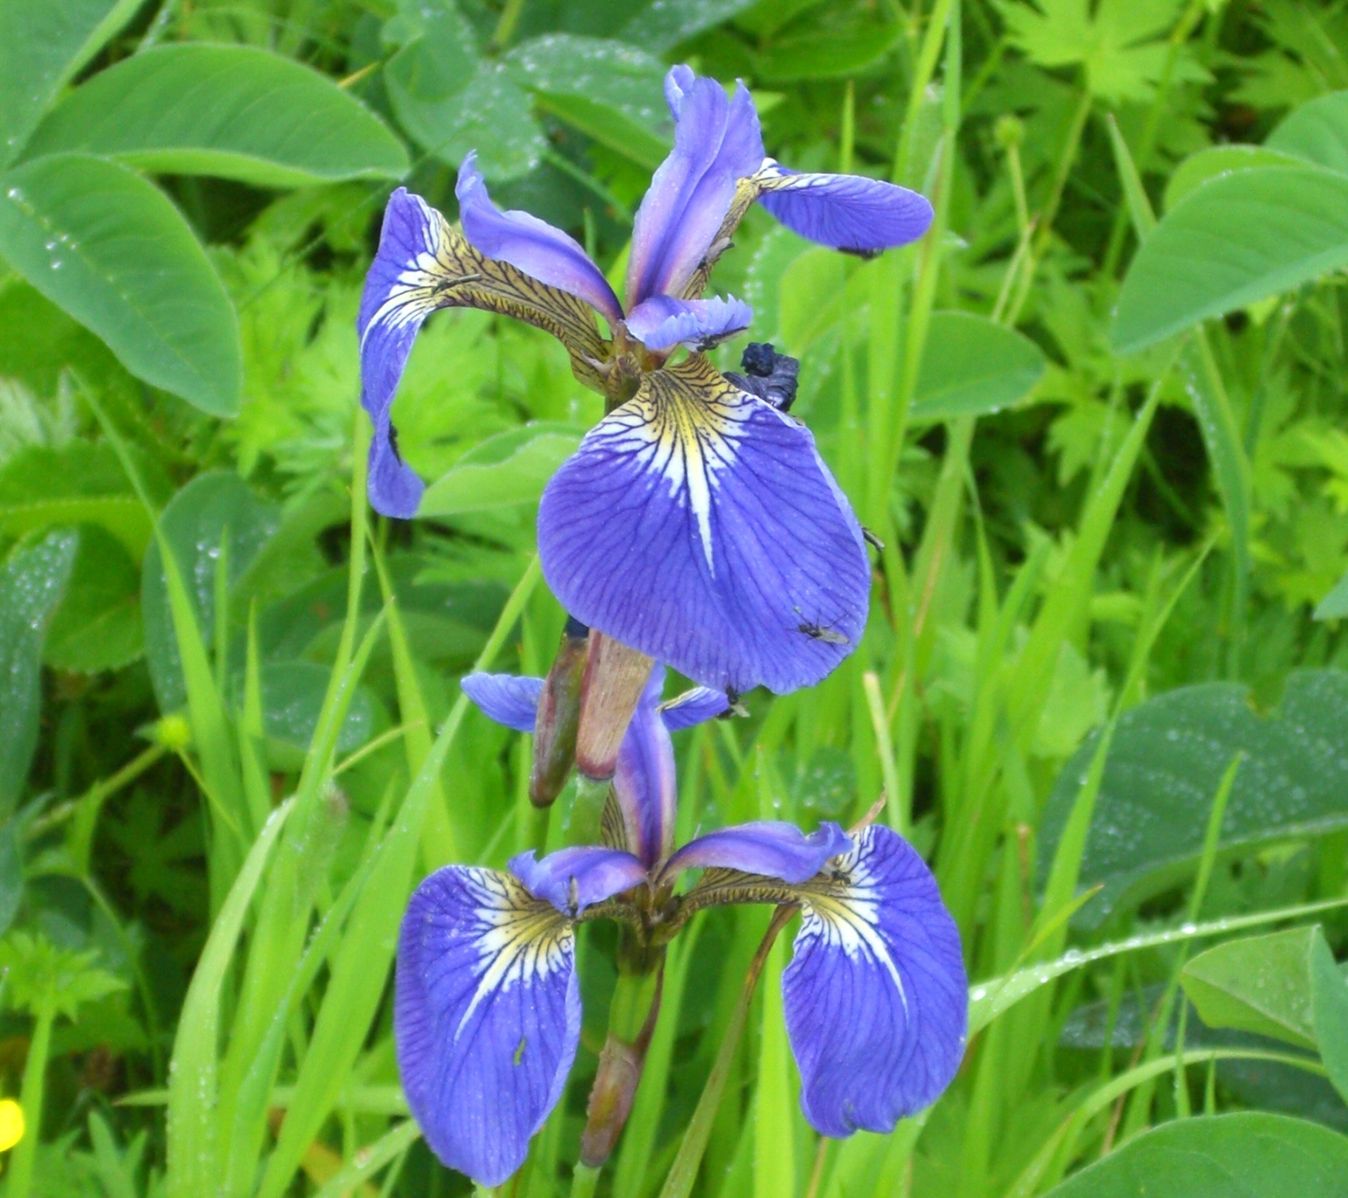
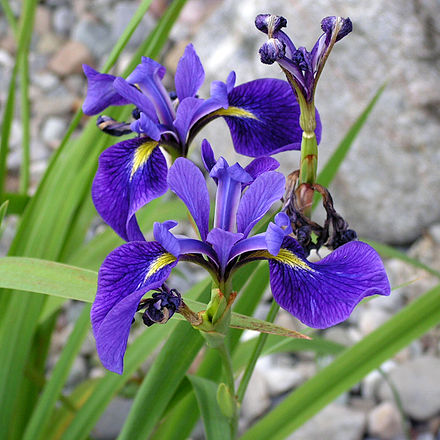
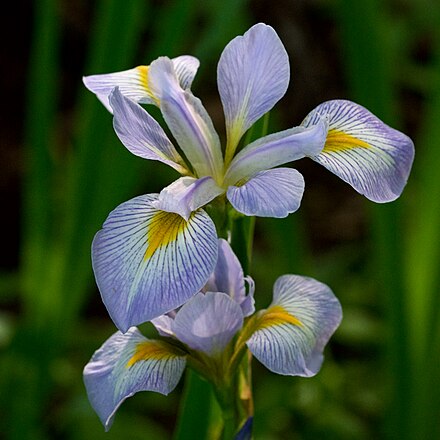
上記画像は、Wikipediaからダウンロードしてきた各アヤメの画像です。左から順にヒオウギアヤメ、ブルーフラッグ、バージニカです。
実行結果#
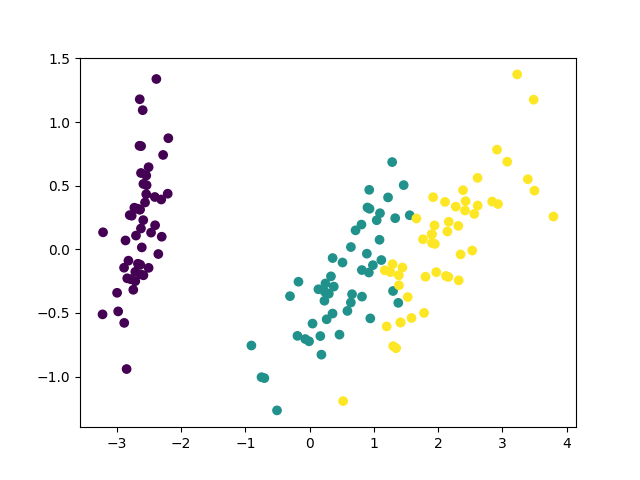
これで、多次元のデータを2次元の散布図として可視化できるようになりました。 ただし、x軸、y軸がどのような意味を持つのかまでは与えられず、自分で考察する必要があります。