課題10-1 2024年度12月の気温予測 #
december_data.csv は,1900〜2023年の12月の平均気温のデータです.
このデータを使って,2024年12月の平均気温を予測してください.
ファイル名は predict_december_temp.py とし,気温データのファイル名は直接プログラム中に書かずに,コマンドライン引数(sys.argv[1])で受け取るようにしてください.
def read_csv(filename):
    x, y = ([], [])
    with open(filename, "r") as f:
        f.readline()    # ヘッダ行を読み飛ばす.
        for line in f:
            pass
    return x, y

x, y = read_csv(sys.argv[1]) # ファイル名はコマンドライン引数で指定する.
# モデル(LinearRegression)のインスタンスを構築する.
# 読み取ったデータを使ってモデルを学習する.
y_pred = model.predict([[2024]]) # x_test を 2024 にして,2024年12月の気温を予測する.

print(f"2024年12月の平均気温は {y_pred[0]} 度(予測)です.")
課題10-2 犬猫画像判定 #
犬と猫の画像を学習し,与えられた画像に写っているのが犬か猫かを判定するプログラムを作成してください.
ファイル名は,cats_or_dogs.py としてください.
犬猫の学習画像は,Kaggleからダウンロードしてください.
Moodleにも同じデータをおいています.
ダウンロードしたzipファイルを展開すると catsとdogsが含まれるディレクトリが得られます.
それで得られたディレクトリをコマンドラインの最初の引数としてプログラムを実行してください.
加えて,適当な犬や猫の画像をコマンドラインの2つ目以降の引数としてプログラムを実行してください.
以下のプログラムの learn_data 関数の中に,決定木(DecisionTree)のモデルを構築するコードを書いてください.
また,適当な犬や猫の画像を与えて,犬か猫かを判定するプログラムを完成させてください.
from PIL import Image
from sklearn import tree # 決定木を用いるには,tree モジュールをインポートする.
import numpy as np
import os
import sys

# basepath 直下の cats と dogs 以下に猫,犬の画像があるとする.
def read_image(basepath): # 画像を読み込む.
    x = []
    y = []
    for file in os.listdir(os.path.join(basepath, "cats")):
        if file.endswith(".jpg"): # jpgファイルのみを対象とする.
            img = Image.open(os.path.join(basepath, "cats", file))
            img2 = img.resize((128, 128))      # 画像の大きさを 128x128に統一する.
            x.append(np.array(img2).flatten()) # 画像を1次元配列に変換し,xに追加する.
            y.append("cats")
    for file in os.listdir(os.path.join(basepath, "dogs")):
        if file.endswith(".jpg"): # jpgファイルのみを対象とする.
            img = Image.open(os.path.join(basepath, "dogs", file))
            img2 = img.resize((128, 128))      # 画像の大きさを 128x128に統一する.
            x.append(np.array(img2).flatten()) # 画像を1次元配列に変換し,xに追加する.
            y.append("dogs")
    return x, y

def learn_data(x, y):
    model = # 決定木(DecisionTree)のモデルを構築する.
    # 構築したモデルを使って,学習する.
    return model

x, y = read_image(sys.argv[1])
model = learn_data(x, y)
for file in sys.argv[2:]:
    img = Image.open(file)
    img2 = img.resize((128, 128)) # 画像の大きさを 128x128に統一する.
    x = np.array(img2).flatten()  # 画像を1次元配列に変換する.
    print(f"{file}: {model.predict([x])}")
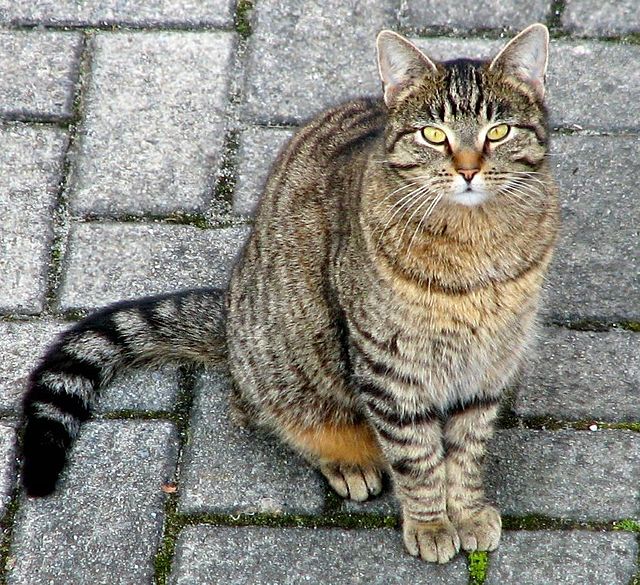
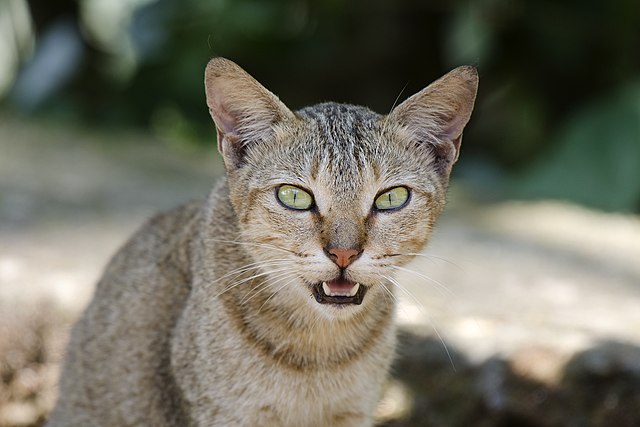
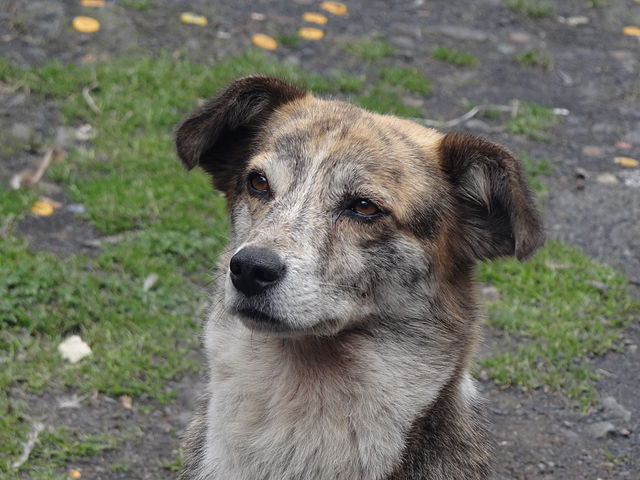
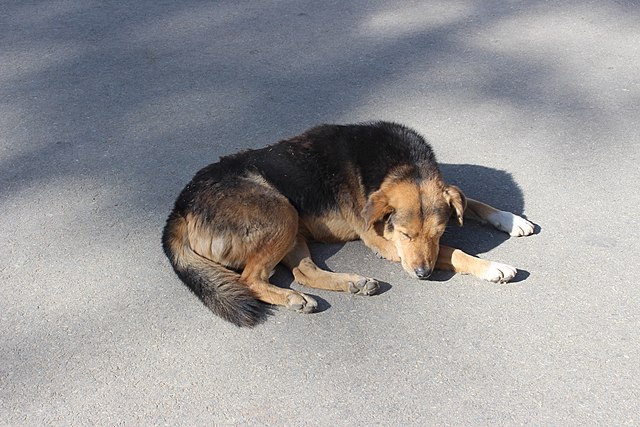
これらは,Wikimediaにある画像です.
これらの画像や,お持ちの犬猫画像を引数に与えてみて,判定できるかを確認してみてください.
判定が間違っていた場合,DecisionTreeClassifier のパラメータを変更してみてください.
DecisionTreeClassifierのパラメーター覧(scikit-learnのドキュメント)
学習済みモデルの保存と読み込み
なお,学習したモデル(model)をファイルに保存しておくことも可能です.
毎回学習すると,128x128程度の画像であっても1〜5分程度時間がかかります.
学習したモデルをファイルに保存しておき,必要な時に読み込むことで,実行時間を短縮できます.
import pickle
with open("cats_or_dogs_model.pickle", "wb") as f:
    pickle.dump(model, f)
以下のファイル(cats_or_dogs_from_model.py)で学習済みのモデルを利用して判定します.
from PIL import Image
import numpy as np
import sys

import pickle
with open(sys.argv[1], "rb") as f:
    model = pickle.load(f)

for file in sys.argv[2:]:
    img = Image.open(file)
    img2 = img.resize((128, 128))
    x = np.array(img2).flatten()
    print(f"{file}: {model.predict([x])}")
課題10-3 ワインの等級の分類 #
以下の手順でワインの等級を分類して散布図を描画するプログラム wine_clustering.py を作成してください.
そして,クラスタリング結果(散布図)に対する考察を,プログラム中の考察に記してください.
- データは,
wine = sklearn.datasets.load_wine()を使って読み込んでください. - 各ワインごとに次の13の変数(
wine.data)があります.これを元にクラスタリングしてください.なお,それぞれの変数の意味は次の通りです.wine.feature_namesからも確認できます.- alcohol(アルコール度数)
- malic_acid(リンゴ酸)
- ash(灰分(かいぶん))
- alcalinity_of_ash(灰分のアルカリ度)
- magnesium(マグネシウム)
- total_phenols(全フェノール含量)
- flavanoids(フラボノイド)
- nonflavanoid_phenols(非フラボノイドフェノール)
- proanthocyanins(プロアントシアニン)
- color_intensity(色の濃さ)
- hue(色相)
- od280/od315_of_diluted_wines(希釈ワイン溶液のOD280/OD315(=280nmと315nmの吸光度の比))
- ChatGPTの解説
- ワイン分析における OD280/OD315 は、ワインを特定の波長(280nmと315nm)で測定した際の吸光度(Optical Density)の比率を指します。一般的には、主にポリフェノール類(特にフラボノイドなど)の含有量や性質を把握する指標として用いられます。
- 280nm付近の吸収: ベンゼン環など芳香族化合物を含む物質(ポリフェノール、タンパク質など)がよく吸収する波長帯
- 315nm付近の吸収: 一部のフェノール類や関連化合物がよく吸収する波長帯
- この2つの吸光度を比率で捉えることで、ワイン中に含まれるフェノール類の量や種類に関する情報(渋味・苦味の強さ、熟成によるフェノール変化の度合いなど)をおおまかに推し量ることができます。ワイン研究では、総ポリフェノール濃度などを推定したり、熟成の評価指標として使われたりすることが多いです。
- ワイン分析における OD280/OD315 は、ワインを特定の波長(280nmと315nm)で測定した際の吸光度(Optical Density)の比率を指します。一般的には、主にポリフェノール類(特にフラボノイドなど)の含有量や性質を把握する指標として用いられます。
- ChatGPTの解説
- proline(プロリン)
- 上記のデータ(
wine.data)を用いて,\(k\)平均法を用いて,クラスタリングを行ってください.- クラスタ数は3としてください.
- alcohol(アルコール度数)とod280/od315_of_diluted_wines(希釈ワイン溶液のOD280/OD315(=280nmと315nmの吸光度の比))の散布図を描いてください.
- クラスタリングの結果を色分けしてください.
from sklearn import datasets
from sklearn import cluster

wine = datasets.load_wine() # ワインのデータセットをロードする.

model = # kMeans を行うオブジェクトを生成する(クラスタ数は3).
# wine.data を対象にクラスタリングを行う.

import matplotlib.pyplot as plt
plt.scatter(...) # wine.data の0列目,11列目で散布図を描画する.
plt.scatter(model.cluster_centers_[:, 0], model.cluster_centers_[:, 11], marker="x", c="red")
plt.show() # 表示する.
実行結果の例 #
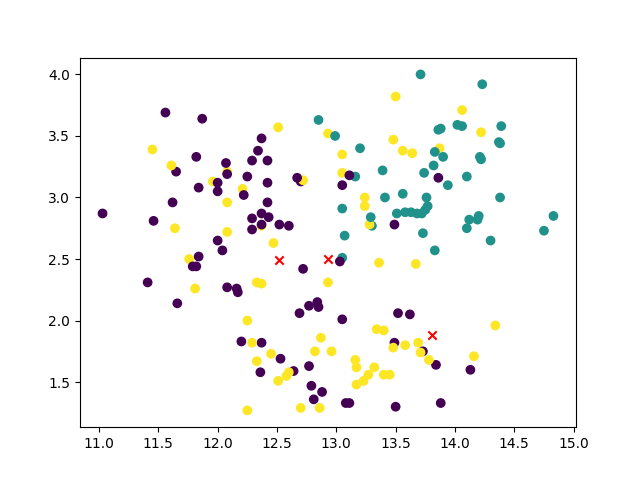
上記の例は,アルコール度数と希釈ワイン溶液のOD280/OD315の比を用いて,ワインの等級を分類した結果です. 散布図を見ると,うまくクラスタリングできていないように見えます. なぜこのような結果になるのかをコメントに記してください.
なお,このデータ(wine)には,等級(wine.target)が含まれています.教師あり学習では,wine.dataを説明変数,wine.targetを目的変数として,ワインの等級予測も行えます.今回はクラスタリング(教師なし学習)ですので,wine.targetは利用しません.
ただ,クラスタリングの予想結果の代わりにwine.targetによって散布図を色分けして表示し,クラスタリング結果と比べてみましょう.
なぜ上手くクラスタリングできなかったかを考える手助けになるかもしれません.