課題09-1 文字列の類似度 #
与えられた文字列同士の類似度を求めるプログラムを作成してください.
文字列同士の類似度は,各文字の出現頻度をベクトルとして表し,そのベクトル間のコサイン類似度で求めます.
文字は全て小文字とし,アルファベット以外の文字は無視してください.
ファイル名は string_similarity.py としてください.
import sys
import numpy as np

def build_array(str):
    vector = [0] * 26      # 各要素に 0 が代入された長さ 26 のリストを作成する.
    s = str.lower()        # str を小文字に変換する.
    for i, c in enumerate(range(ord('a'), ord('z') + 1)): # 'a' から 'z' までの各文字 c に対して処理を行う.
        # ord は文字を Unicode に変換する関数である.
        # 'a' を ascii コードに変換し,c を足して,文字に変換する.
        # str に含まれる c の数を数えて,vector の対応する要素に代入する.
        vector[i] = s.count(chr(c))
    return np.array(vector)

def cossim(v1, v2):
    # ここで,ベクトル v1, v2 のコサイン類似度を計算して返す.

for i, str1 in enumerate(sys.argv[1:]): # コマンドライン引数の文字列を総当たりで比較する.
    for str2 in sys.argv[i + 2:]:
        v1 = build_array(str1) # 文字列 str1 のベクトルを作成する.
        v2 = build_array(str2) # 文字列 str2 のベクトルを作成する.
        print(f'cossim({str1:15}, {str2:15}) = {cossim(v1, v2)}') # 類似度を計算し,表示する.
実行例 #
python3 string_similarity.py abracadabra 'This is a pen' "Madam, I'm Adam" "I can fly" "open sesame"
cossim(abracadabra    , This is a pen  ) = 0.22587697572631282
cossim(abracadabra    , Madam, I'm Adam) = 0.6113470158144013
cossim(abracadabra    , I can fly      ) = 0.3833259389999639
cossim(abracadabra    , open sesame    ) = 0.19920476822239894
cossim(This is a pen  , Madam, I'm Adam) = 0.2636248650982481
cossim(This is a pen  , I can fly      ) = 0.40406101782088427
cossim(This is a pen  , open sesame    ) = 0.629940788348712
cossim(Madam, I'm Adam, I can fly      ) = 0.31068488300060004
cossim(Madam, I'm Adam, open sesame    ) = 0.30999370331685144
cossim(I can fly      , open sesame    ) = 0.1781741612749496
課題09-2 成績の統計 #
score.csv は,とある講義の学生の成績をまとめた csv ファイルです. この csv ファイルには,各学生ごとに以下の内容が記載されています.
- ID
- 最終成績
- 試験の点数
- 最終課題の点数
- 週次課題の点数
- 小テスト1の点数
- 小テスト2の点数
この csv ファイルを読み込み,学生ごとの類似度をコサイン類似度で求めるプログラムを作成してください.
ファイル名は students_similarity.py としてください.
まず,csv ファイルを読み込み,各学生の6つの点数を読み込みます. 次に,学生の点数を6次元のベクトルとして扱います. そして,学生ごとに総当たりでコサイン類似度を計算し,結果を出力します.
import sys
import numpy as np

def open_csv(filename):
    students = dict()
    with open(filename, "r") as f:
        f.readline()    # ヘッダ行を読み飛ばす.
        for line in f:
            scores = []
            cols = line.strip().split(",") # 改行を削除し,コンマで分割する.
            for item in cols[1:]:
                scores.append(float(item))       # 文字列を浮動小数点変数に変換して scores に追加する.
            students[cols[0]] = np.array(scores) # scores を numpy 配列に変換して students に追加する.
    return students

def similarity(v1, v2):
    norm1 = # ベクトル v1 のノルムを計算する.
    norm2 = # ベクトル v2 のノルムを計算する.
    if norm1 == 0 and norm2 == 0:  # どちらも0の場合は一致するので,1.0を返す.
        return 1.0
    elif norm1 == 0 or norm2 == 0: # どちらかが0の場合は一致しないので,0.0を返す.
        return 0.0
    return # ベクトル v1 と v2 のコサイン類似度を計算する(norm1, norm2 のどちらかが0の場合は0除算が発生するため,計算できない).

students = open_csv(sys.argv[1]) # コマンドライン引数のファイルを読み込む.
ids = list(students.keys())      # 学生の ID を取得する.
similarities = np.zeros((len(ids), len(ids))) # 類似度を格納する行列を作成する.

for i, id1 in enumerate(ids):
    for j, id2 in enumerate(ids):
        if id1 == id2: # 右上と左下で同じ結果になるので,左下だけ計算する.
            break      # 右上の場合は計算しない.
        similarities[i, j] = similarity(students[id1], students[id2]) # 類似度を計算して格納する.

for id in ids:
    print(f",{id}", end="") # ヘッダを表示する.
print()
for i, id1 in enumerate(ids):
    print(f"{id1}", end="")
    for j, id2 in enumerate(ids):
        if id1 == id2:
            break
        print(f",{similarities[i, j]:.2f}", end="")
    print()
178行,178列の大きな表が出力されますので,結果をリダイレクトしてファイルに保存してください.
解答例のプログラムを実行した結果は similarities.csv からダウンロードできますので,実行結果の確認に用いてください.
python3 students_similarity.py score.csv > similarities.csv
📥 similarities.csv(実行結果)のダウンロード
発展問題1 別の類似度算出方法(ユークリッド距離)
学生間の類似度を測定するのに,コサイン類似度以外の方法を用いてみましょう. その一つに距離を用いる方法があります. 類似度は,1に近いほど類似し,0に近いほど類似しませんが,距離は0に近いほど類似していることになります. また,距離を単純に計算すると,0〜1の範囲に収まりません. そのため,最大値で割って0〜1の範囲に収めて(正規化する)から,1から引くことで,類似度に変換します.
距離を測定する方法の一つにユークリッド距離があります.2点間の直線距離を計算する方法です. 他にマンハッタン距離(碁盤の目状の経路の距離)やチェビシェフ距離(各座標の差の絶対値の最大値)などがありますが,ここではユークリッド距離を用いてみましょう.
students_similarity2.py として,students_similarity.py の similarity 関数を distance 関数に変更して,ユークリッド距離を計算するプログラムを作成してください.
def distance(v1, v2):
    return np.linalg.norm(v1 - v2) # v1, v2間のユークリッド距離を計算する.
# 上記の similarity 関数を distance 関数に変更して,類似度を計算する.
# また,similarities 行列を計算したあと,距離の最大値(max)を求める.
# その後,similarities 行列の各要素に対して,(1 - similarities[i, j] / max) を計算して,類似度に変換する.
発展問題2 類似度の分布
学生間の類似度がどの程度分布しているのかを確認するため,ヒストグラムを作成しましょう.
そのために,類似度の一覧をリストに格納し,matplotlib を用いてヒストグラムを作成します. similarities 行列をそのまま描画するのではなく,各要素をリストに格納して,そのリストを用いてヒストグラムを描画します.
課題09-3 リサジュー曲線(Lissajous Curve) #
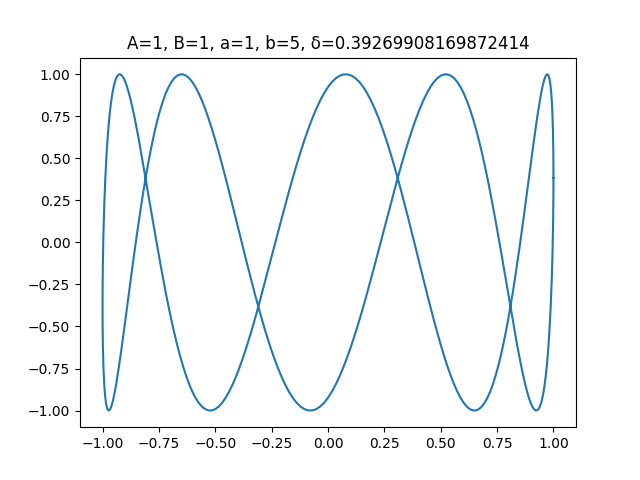
以下の式で表されるリサジュー曲線を描画する Python プログラムを作成してください.
lissajous.py というファイル名で保存してください.
完成すれば,a, b, delta の値を変更して,様々なリサジュー曲線を描画してみましょう.
\( x = A \cos(a t) \\ y = B \sin(b t + \delta) \)
import math
import matplotlib.pyplot as plt

A = 1
B = 1

a = 3
b = 4
delta = math.pi / 4

x = []
y = []
for i in range(0, 361): # 0〜360度まで.
    t = i * (math.pi / 180)       # ラジアンに変換する.
    # x に値を追加する(x.append(...)).
    # y に値を追加する(y.append(...)).

plt.plot(x, y)
plt.text(0, 1.15, f"A={A}, B={B}, a={a}, b={b}, δ={delta}", fontsize=12, ha="center")
plt.axis("equal") # グラフの縦横比を 1:1 にする.
plt.show()
実行結果の例 #
クリックするとa,b,delta の値が変わります.
リンク #
課題09-4 成績分布(散布図) #
課題09-2 成績の統計
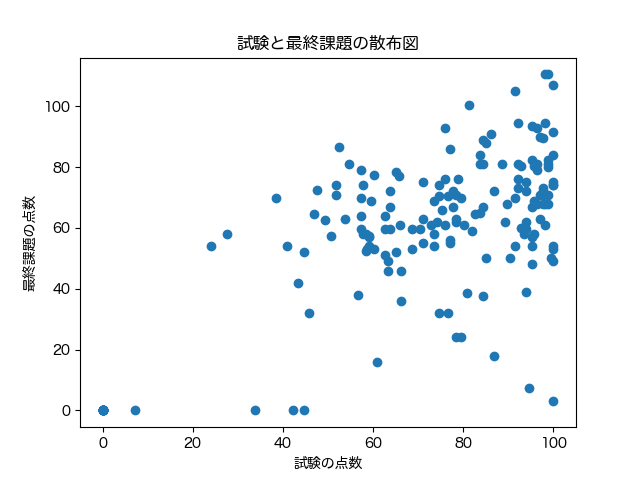
で扱った成績データを散布図で表示するプログラムを作成してください.
\(x\)軸に試験の点数,\(y\)軸に最終課題の点数をプロットしてください.
成績データのファイル名はプログラム中に直接書かず,コマンドライン引数で指定できるようにしてください.
ファイル名は score_scatter.py としてください.
import sys
import matplotlib.pyplot as plt

def open_csv(filename):
    x = []
    y = []
    with open(filename, 'r') as f:
        f.readline()    # ヘッダ行を読み飛ばす.
        for line in f:
            cols = line.strip().split(",") # 改行を削除し,コンマで分割する.
            # 試験の点数(3列目, float)を x に追加する.
            # 最終課題(4列目, float)の点数を y に追加する.
    return x, y

x, y = open_csv(sys.argv[1]) # コマンドライン引数のファイルを読み込む.
plt.rcParams["font.family"] = "Hiragino Maru Gothic Pro" # フォントをヒラギノ丸ゴシックに設定する.
plt.title('試験と最終課題の散布図')
plt.xlabel("試験の点数")
plt.ylabel("最終課題の点数")
# plt.axis("equal") # グラフの縦横比を 1:1 にする.
# x, y の散布図を描画する.
実行結果 #